Blog

  • Une appli android pour le fun… mais pas seulement

    Nous avons vu dans le précédent article (qui commence à daté un peu) que Zabbix nous permettait de catégoriser nos serveurs et de faire des interrogations facilement via son api REST.

    Et si on s’en servait pour piloter des caméras vidéos de Rasperry Pi? On va enregistrer les serveurs sous Zabbix et créer une application android pour allumer et éteindre les caméras mais aussi voir le flux vidéo.

    Pour configurer les caméras, je me suis basé sur cet article. Il est plutôt bien fait et encore à jour.

    J’ai juste ajouté un agent zabbix sur la machine afin que la machine remonte dans l’inventaire.

    Sur le serveur Zabbix, j’ai déclaré mes cameras dans un groupe « original » nommé cameras.

    Il ne reste plus qu’a développer l’application mobile.

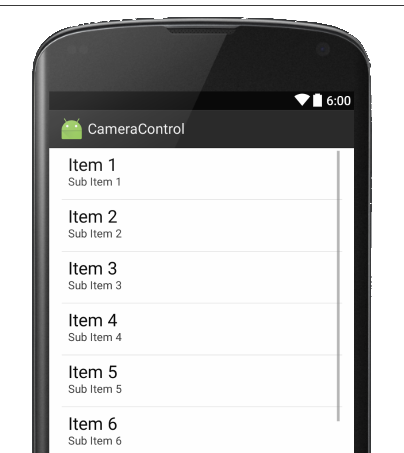
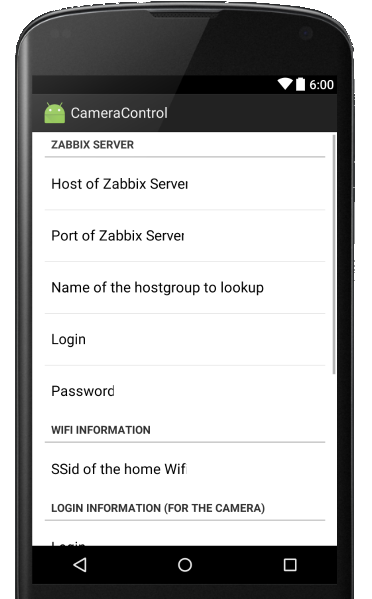
    Dans un premier temps, je défini un écran de préférence qui permettra de renseigner l’adresse du serveur Zabbix (il faut bien un point de départ pour collecter l’information).

    preference

    Dans cette fenêtre, on peut aussi définir
    – le login et le mot de passe pour se logguer aux caméras.
    – Le nom du SSID du wifi de la maison. Cela permet de choisir le type de connexion pour se connecter aux serveurs.
    – Les informations d’une passerelle pour se connecter aux caméras de l’extérieur.

    Une fois ces informations renseignées, il ne reste plus qu’a interroger le serveur zabbix, pour récupérer les différents serveurs

    list

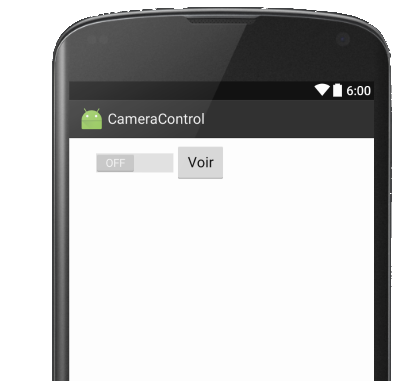
    Une fois la liste des serveurs établies, on peut cliquer sur un élément pour voir son détail:

    détail

    Sur cette fenêtre, on pourra connaître l’état de la caméra (On / OFF) et changer le statut si besoin. Dans ce cas, l’application lancera une commande ssh pour arrêter le service motion sur le rasperry PI.

    SshHelper sshHelper = new SshHelper(host,cameraLogin.getLogin(), cameraLogin.getPassword(),port);
    sshHelper.execute("sudo service motion " + command);

    Le bouton Voir permet de consulter le flux vidéo. Il va lancer firefox et afficher le flux de la caméra.

    Il suffit juste de lancer un Intent avec la bonne url:

    Intent intent = new Intent(Intent.ACTION_VIEW, Uri.parse("http://" + host + ":"+port));
    intent.setComponent(new ComponentName("org.mozilla.firefox", "org.mozilla.firefox.App"));
    getActivity().startActivity(intent);

    Le code source est ici si vous voulez approfondir le sujet.

    J’ai volontairement laissé de côté l’aspect connections depuis l’extérieur. Cela fera peut être l’objet d’un prochain article.


  • Zabbix et son api REST

    Sans trop faire de teasing sur le prochain article, j’avais besoin de récupérer de façon dynamique une liste de serveurs. Je me suis dis que Zabbix pouvait être une bonne solution sachant qu’il est possible de regrouper différent serveur sous la forme de host groups.

    J’ai pu découvrir l’API rest de zabbix qui est plutôt simple à utiliser et très bien documenter.

    Mon cas d’utilisation va se décomposer en 3 étapes:

    1. Authentification
    2. Récupération du host groups
    3. Récupération des hosts

    Authentification

    La première étape est de récupéré un token d’authentification. Pour cela,il faut poster une requête JSON de la forme :

    curl -X POST "http://monZabbix

    avec auth.dat contenant:

    {
    "jsonrpc": "2.0",
    "method": "user.login",
    "params": {
    "user": "Admin",
    "password": "****"
    },
    "id": 1,
    "auth": null
    }

    Cela nous renvoie une réponse la forme:

    {"jsonrpc":"2.0","result":"7c3bdad828fc6ed7c49f1c1ff3c819a4","id":1}

    La partie importante est la chaîne de caractère qui suit result. Il s’agit du token que l’on va réutiliser pour les appels suivants.

    Récupération du host groups

    Avant de pouvoir récupérer les serveurs d’un groupe, je dois récupérer l’id de ce groupe. Pour l’instant je ne connais que le nom toto.

    On va donc refaire une interrogation. Mais avec le json suivant:

    {
    "jsonrpc": "2.0",
    "method": "hostgroup.get",
    "params": {
    "output": "extend",
    "filter" : {
    "name" : "toto"
    }
    },
    "id":"2",
    "auth": "7c3bdad828fc6ed7c49f1c1ff3c819a4"
    }


    On retrouve bien le token d’authentification dans la valeur du champ auth et le nom toto dans la valeur du champ name. Il s’agit d’un filtre sur les hostgroups.

    Le résultat va être de la forme:

    {"jsonrpc":"2.0","result":[{"groupid":"8","name":"toto","internal":"0","flags":"0"}],"id":"2"}

    La partie à conserver est la valeur du groupid. C’est que nous allons utiliser pour la suite.

    Récupération des hosts

    Maintenant que nous avons l’id du hostgroup, nous pouvons interroger zabbix pour avoir la liste des serveurs de ce groupe:

    {
    "jsonrpc": "2.0",
    "method": "host.get",
    "params": {
    "output": [
    "hostid",
    "host"
    ],
    "groupids": "8"
    },
    "id": 2,
    "auth": "7c3bdad828fc6ed7c49f1c1ff3c819a4"
    }

    Le résultat est de la forme:

    {"jsonrpc":"2.0","result":[
    {"hostid":"10107","host":"pc-bureau"},
    {"hostid":"10114","host":"pc-bureau2}
    ],
    "id":2}

    Et voila, en quelques appels, on peut utiliser zabbix comme un catalogue et récupérer de façon dynamique les différents éléments qui constitue le réseau (domestique ou professionnel).

  • Mais pourquoi je loggue autant?

    La semaine dernière, j’ai trouvé un problème intéressant. Lors de la mise à jour d’une application, celle-ci a commencé à logguer en mode DEBUG de façon aléatoire. Sur certains serveurs tout marchait correctement, mais sur d’autres, non. En apparence, tout semblait normal, le fichier log4j.properties n’avait pas changé.

    En regardant les logs, un message à attiré mon attention:

    SLF4J: Class path contains multiple SLF4J bindings. 
    SLF4J: Found binding in [jar:.../slf4j-log4j12-1.6.4.jar!/org/slf4j/impl/StaticLoggerBinder.class] 
    SLF4J: Found binding in [jar:.../logback-classic.1.0.3.jar!/org/slf4j/impl/StaticLoggerBinder.class] 
    SLF4J: See http://www.slf4j.org/codes.html#multiple_bindings for an explanation.

    Chose intéressante, sur les serveurs à problème le message était plutôt de ce type:

    SLF4J: Class path contains multiple SLF4J bindings.
    SLF4J: Found binding in [jar:.../logback-classic.1.0.3.jar!/org/slf4j/impl/StaticLoggerBinder.class] 
    SLF4J: Found binding in [jar:.../slf4j-log4j12-1.6.4.jar!/org/slf4j/impl/StaticLoggerBinder.class] 
    SLF4J: See http://www.slf4j.org/codes.html#multiple_bindings for an explanation.

    SLF4j va prendre la première implémentation qu’il trouve. Dans notre cas ce sera logback-classic sur certains serveurs (cela va dépendre du chargement des classes dans le classloader).

    Là où le problème arrive c’est que nous ne sommes pas supposés utiliser logback mais plutôt log4j. Nous n’avons pas de fichier de configuration de logback.

    En suivant la documentation, voici ce qui se passe:

    1. Let us begin by discussing the initialization steps that logback follows to try to configure itself:
      
      Logback tries to find a file called logback.groovy in the classpath.
      
      If no such file is found, logback tries to find a file called logback-test.xml in the classpath.
      
      If no such file is found, it checks for the file logback.xml in the classpath..
      
      If no such file is found, and the executing JVM has the ServiceLoader (JDK 6 and above) the ServiceLoader will be used to resolve an implementation of com.qos.logback.classic.spi.Configurator. The first implementation found will be used. See ServiceLoader documentation for more details.
      
      If none of the above succeeds, logback configures itself automatically using the BasicConfigurator which will cause logging output to be directed to the console.

    Nous n’avons aucun de ces fichiers,  donc logback va écrire dans la console. Mais avec quel niveau de logs ? Et bien c’est écrit dans la doc :

    by default the root logger is assigned theDEBUG level.

    C’était donc ca. Un manque de fichier de configuration et notre serveur passe en mode DEBUG.

    Mais pourquoi avoir rajouter une telle librairie (logback-classic)?

    Ce n’était pas volontaire, c’est une dépendance transitive qui est remontée en ajoutant une autre dépendance à un projet.

    conclusion 1: toujours surveiller les dépendances remontées par les librairies

    conclusion 2: toujours prêter attention aux messages dans les logs

    PS: dans la version 1.6.6, slf4j va indiquer en plus dans les logs, la classe StaticLoggerBinder qu’il utilise. Cela permet de contrôler encore mieux ce qu’il se passe réellement sur le serveur.

  • Zabbix Agent

    Voyons maintenant comment configurer un agent Zabbix pour monitorer un nouveau serveur.

    Il suffit d’installer le package zabbix-agent

    sudo apt-get install zabbix-agent

    et de faire un peu de configuration

    sudo vi /etc/zabbix/zabbix_agentd.conf
    # Il faut mettre ici, l'ip du serveur zabbix. L'agent ne répondra qu'a cette ip
    Server=Zabbix-server
    
    # ip du serveur zabbix pour faire de l'active check
    ServerActive=Zabbix-server
    
    # Afin que l'agent se base sur le nom de la machine, j'ai commenté la première ligne et commentée la seconde
    #Hostname=Zabbix server
    HostnameItem=system.hostname

    On redemarre l’agent

    sudo service zabbix-agent restart

    Il faut ensuite l’ajouter dans la configuration de zabbix:

    Configuration -> hosts -> New hosts.

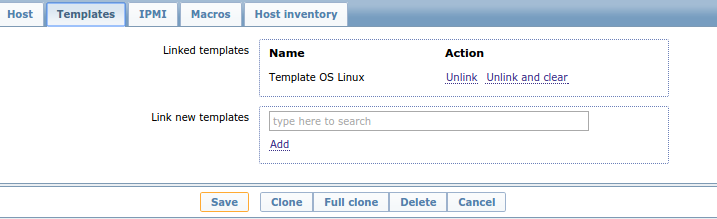
    Dans cette ecran, il ne faut pas oublier d’ajouter un template:

    template


    Au bout de quelques instants, vous devriez voir dans les logs (comme précédemment):

    enabling Zabbix agent checks on host "xxxx": host became available

    Et voila, il ne reste plus qu’a ajouter le monitoring sur les autres serveurs.

  • De cacti à Zabbix (en passant par nagios)

    Cela fait plusieurs années que j’utilise cacti. Mais j’ai de plus en plus de mal à configurer mes nouveaux serveurs. Je me suis donc dit qu’il était peut être temps de tester une autre solution.

    (suite…)

  • Gestion de session avec un cluster redis – suite et fin

    suite à une remarque de Remy, j’ai modifié le test gatling pour bien vérifier qu’on récupère la même session lorsque le slave a pris la place du master.

    Pour cela, dans le test, je fais une boucle sur la page index qui indique le nom de la personne si elle est logguée. J’utilise les fonctions de gatling de check pour vérifier que l’information est bien présente.

    package com.axioconsulting
    
    import scala.concurrent.duration._
    
    import io.gatling.core.Predef._
    import io.gatling.http.Predef._
    import io.gatling.jdbc.Predef._
    
    class Session extends Simulation {
    
    val httpProtocol = http
    .baseURL("http://172.17.0.3:8080")
    .inferHtmlResources(WhiteList(), BlackList())
    .acceptHeader("text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8")
    .acceptEncodingHeader("gzip, deflate")
    .acceptLanguageHeader("en")
    .connection("keep-alive")
    .doNotTrackHeader("1")
    .userAgentHeader("Mozilla/5.0 (X11; Ubuntu; Linux x86_64; rv:38.0) Gecko/20100101 Firefox/38.0")
    
    val headers_1 = Map("Accept" -> "image/png,image/*;q=0.8,*/*;q=0.5")
    
    val uri1 = "http://172.17.0.3:8080"
    
    val scn = scenario("Session")
    .exec(http("Login")
    .get("/session-webapp/login.html?userName=benoit")
    )
    .pause(7).during(5 minutes, "during_0"){
    exec(http("refresh_1")
    .get("/session-webapp/index.jsp").check(status.is(200)).check(regex("benoit").exists)).pause(1);
    };
    
    setUp(scn.inject(atOnceUsers(1))).protocols(httpProtocol)
    }

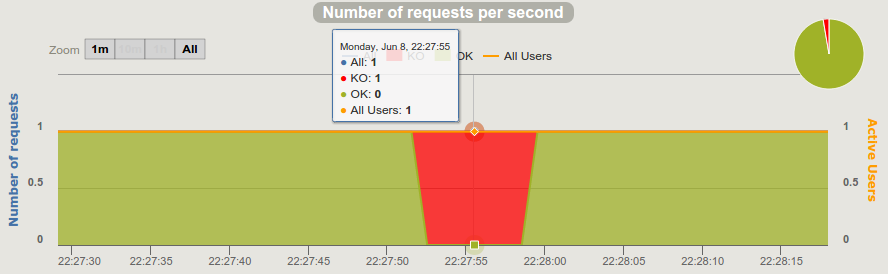
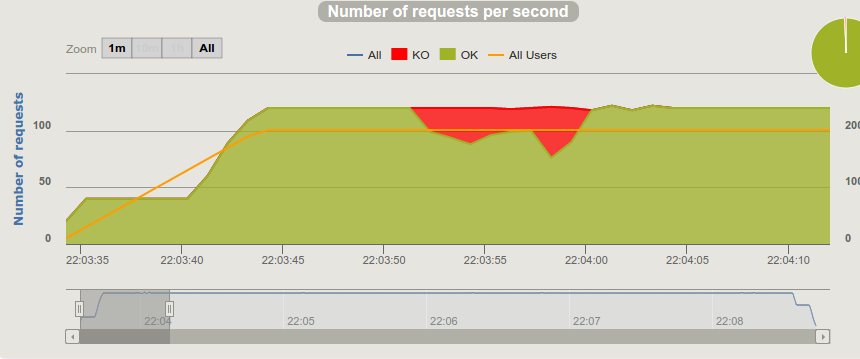
    Ce qui donne bien:

    gatling


    error

    Pendant le delai d’indisponibilité, on a des erreurs de type 500 et ensuite on repart bien sur la bonne session avec les bonnes données.

    L’erreur 500 peut être traitée dans la valve pour gérer un peu ce type d’erreur et rediriger l’utilisateur vers une page adaptée mais ce n’est pas l’objet de cette article.

  • Gestion de session avec un cluster redis – suite

    Maintenant que nous avons une application à tester, nous pouvons utiliser gatling pour simuler de la charge et voir comment se comporte l’application en cas de chute d’un noeud master.

    Le script se contente de se logguer, et de rafraîchir 3 fois la page index. Il va injecter 20 users par seconde pendant 5 minutes:

    package com.axioconsulting
    
    import scala.concurrent.duration._
    
    import io.gatling.core.Predef._
    import io.gatling.http.Predef._
    import io.gatling.jdbc.Predef._
    
    class Session extends Simulation {
    
    val httpProtocol = http
    .baseURL("http://172.17.0.83:8080")
    .inferHtmlResources(WhiteList(), BlackList())
    .acceptHeader("text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8")
    .acceptEncodingHeader("gzip, deflate")
    .acceptLanguageHeader("en")
    .connection("keep-alive")
    .doNotTrackHeader("1")
    .userAgentHeader("Mozilla/5.0 (X11; Ubuntu; Linux x86_64; rv:38.0) Gecko/20100101 Firefox/38.0")
    
    val headers_1 = Map("Accept" -> "image/png,image/*;q=0.8,*/*;q=0.5")
    
    val uri1 = "http://172.17.0.83:8080"
    
    val scn = scenario("Session")
    .exec(http("Login")
    .get("/session-webapp/login.html?userName=benoit")
    )
    .pause(7)
    .exec(http("refresh_1")
    .get("/session-webapp/index.jsp")
    .resources(http("request_4")
    .get(uri1 + "/favicon.ico")))
    .pause(1)
    .exec(http("refresh_2")
    .get("/session-webapp/index.jsp")
    )
    .pause(1)
    .exec(http("refresh_3")
    .get("/session-webapp/index.jsp")
    )
    
    /*setUp(scn.inject(atOnceUsers(1))).protocols(httpProtocol)*/
    setUp(scn.inject(constantUsersPerSec(20) during(5 minutes))).protocols(httpProtocol)
    }


    J’ai arrêté un noeud master avec la commande supervisor :

    supervisor> stop redis-1
    redis-1: stopped

    Ce qui nous donne:

    gatling-session

    On peut voir qu’il y a des erreurs pendant près de 10s, le temps que le slave prenne le pas sur le master.

    Il faudrait peut être modifier le session-manager pour tenir de ce problème. A suivre…

  • Gestion de session avec un cluster redis

    Voyons comment mettre en pratique les deux articles précédents (ici et ici).

    Les choses n’étant pas encore très évolués du cote de spring-data-redis pour le mode cluster, je suis revenu sur la version de session-webapp utilisant une valve tomcat.

    Les seules modifications apportées sont la suppression de l’image redis (je vais utiliser la version cluster) et l’utilisation d’une nouvelle image docker de base pour les serveurs Tomcat.

    En effet, j’ai modifié la valve pour utiliser la nouvelle classe JedisCluster à la place de Jedis.
    Mais pour que cela fonctionne, j’ai du utilisé la version 3.0.0-SNAPSHOT de jedis. La version releasée actuelle n’implémente pas les commandes binary par la lecture/ecriture.

    J’ai du également modifié l’image docker pour le cluster redis car par default, le cluster est configuré en 127.0.0.1. Mais quand le client java essaye de découvrir la topologie du cluster, il obtient ces ips, et ne peux pas se connecter aux autres noeuds. La modification permet d’établir la connexion sur l’ip du conteneur.

    Il ne reste plus qu’à lancer tout ce petit monde:

    redis:

    /docker-redis-cluster$ make-clean && make-build && make-run

    tomcat & haproxy

    /session-webapp$ ./stop_all.sh ;  mvn clean install && ./start_all.sh


    Lorsque je crée une session, je la vois bien sur un noeud redis et sur un autre noeud, je vois bien le message de redirection:

    http://172.17.0.29:8080/session-webapp/login.html?userName=toto


    docker-redis-cluster$ redis-cli -p 7000
    127.0.0.1:7000> get 9C58CB03A3E0898CEA70420FA681B626
    "\xac\xed\x00\x05w\b\x00\x00\x01M\xcf\x82%\xc6sr\x00\x0ejava.lang.Long;\x8b\xe4\x90\xcc\x8f#\xdf\x02\x00\x01J\x00\x05valuexr\x00\x10java.lang.Number\x86\xac\x95\x1d\x0b\x94\xe0\x8b\x02\x00\x00xp\x00\x00\x01M\xcf\x82%\xc6sq\x00~\x00\x00\x00\x00\x01M\xcf\x84\xd43sr\x00\x11java.lang.Integer\x12\xe2\xa0\xa4\xf7\x81\x878\x02\x00\x01I\x00\x05valuexq\x00~\x00\x01\x00\x02\xbf sr\x00\x11java.lang.Boolean\xcd r\x80\xd5\x9c\xfa\xee\x02\x00\x01Z\x00\x05valuexp\x00sq\x00~\x00\x06\x01sq\x00~\x00\x00\x00\x00\x01M\xcf\x84\xd43t\x00 9C58CB03A3E0898CEA70420FA681B626sq\x00~\x00\x04\x00\x00\x00\x02t\x00\buserNamet\x00\x06benoitt\x00\aproductsr\x00$com.axioconsulting.test.bean.ProduitW\x02ts6\x14\xa0\xee\x02\x00\x02J\x00\x05countL\x00\x02idt\x00\x12Ljava/lang/String;xp\x00\x00\x00\x00\x00\x00\x00\x0et\x00\x05pates"
    127.0.0.1:7000> 
    docker-redis-cluster$ redis-cli -p 7001
    127.0.0.1:7001> get 9C58CB03A3E0898CEA


    Les sources sont ici:
    tomcat-session-manager
    webapp
    docker-redis-cluster


  • Redis Cluster

    Voici le résultat de quelques tests réalisé sur le cluster redis (3.0)

    Je suis parti cette image docker https://github.com/Grokzen/docker-redis-cluster

    Après un inévitable

    make build

    l’image est prête à être utilisé. Par défaut, cette image va lancer 3 nœuds masters et 3 nœuds slaves (1 par nœud master).

    Lançons la commande

    $ make run
    Running docker image...
    docker run -d -p 7000:7000 -p 7001:7001 -p 7002:7002 -p 7003:7003 -p 7004:7004 -p 7005:7005 -p 7006:7006 -p 7007:7007 --cidfile /tmp/grokzen-redis-cluster.cid -i -t grokzen/redis-cluster
    eb5c09e1053fd008e6da693b2bb5a60548cbd41c8c2d8139f9bd89328c255d3b

    On peut voir que les ports 7000 à 7005 sont remontés sur le système hôte. Ce sera plus facile pour interroger redis directement.

    $ redis-cli -p 7000
    127.0.0.1:7000> cluster info
    cluster_state:ok
    cluster_slots_assigned:16384
    cluster_slots_ok:16384
    cluster_slots_pfail:0
    cluster_slots_fail:0
    cluster_known_nodes:6

    En interrogeant redis, il y a bien 6 nœuds qui constituent le cluster (cluster_known_nodes).

    La répartition des clés sautent aux yeux quand on essaye d’insérer une valeur

    127.0.0.1:7000> set toto 4
    (error) MOVED 9738 127.0.0.1:7001

    En lisant ce blog, on voit que la clé de répartition, se calcule comme suit:

    HASH_SLOT = CRC16(key) mod 16384

    Dans notre cas, key=toto ce qui donne hash_slots=9548

    Si on inspecte le cluster, on obtient

    $ docker exec -it 4c1589c09148 /bin/bash
    root@4c1589c09148:/# /redis/src/redis-trib.rb check 127.0.0.1:7000
    Connecting to node 127.0.0.1:7000: OK
    Connecting to node 127.0.0.1:7005: OK
    Connecting to node 127.0.0.1:7001: OK
    Connecting to node 127.0.0.1:7002: OK
    Connecting to node 127.0.0.1:7003: OK
    Connecting to node 127.0.0.1:7004: OK
    >>> Performing Cluster Check (using node 127.0.0.1:7000)
    M: c6f94a5f136caf7eccf2d207dc5d6cdccdc44885 127.0.0.1:7000
    slots:0-5460 (5461 slots) master
    1 additional replica(s)
    S: fa1ba98d286a7db6ad6e4f7b37999d79c2671a97 127.0.0.1:7005
    slots: (0 slots) slave
    replicates 359cc89af7c1654d9fa408ad91abbd1ddc1906f5
    M: 63e73580b843d499b665a7385967268528e836e9 127.0.0.1:7001
    slots:5461-10922 (5462 slots) master
    1 additional replica(s)
    M: 359cc89af7c1654d9fa408ad91abbd1ddc1906f5 127.0.0.1:7002
    slots:10923-16383 (5461 slots) master
    1 additional replica(s)
    S: e7520e9f5c6a43fca5bd1dd3e514278fa036fa80 127.0.0.1:7003
    slots: (0 slots) slave
    replicates c6f94a5f136caf7eccf2d207dc5d6cdccdc44885
    S: f86b2c4604bebddec390f032faa7df484d576afe 127.0.0.1:7004
    slots: (0 slots) slave
    replicates 63e73580b843d499b665a7385967268528e836e9
    [OK] All nodes agree about slots configuration.
    >>> Check for open slots...
    >>> Check slots coverage...
    [OK] All 16384 slots covered.

    On peut donc voir que notre valeur est contenu entre 5461 et 10922 et donc est géré par le master 63e73580b843d499b665a7385967268528e836e9 soit le l’instance redis sur le port 7001. Ce qui est bien conforme avec l’information fourni par redis.

    Que se passe t’il si on arrête un slave:

    root@4c1589c09148:/# supervisorctl 
    redis-1 RUNNING pid 14, uptime 0:09:39
    redis-2 RUNNING pid 16, uptime 0:09:39
    redis-3 RUNNING pid 15, uptime 0:09:39
    redis-4 RUNNING pid 11, uptime 0:09:39
    redis-5 RUNNING pid 10, uptime 0:09:39
    redis-6 RUNNING pid 13, uptime 0:09:39
    redis-7 RUNNING pid 12, uptime 0:09:39
    redis-8 RUNNING pid 17, uptime 0:09:39
    supervisor> stop redis-6
    redis-6: stopped

    En relançant la commande

    root@4c1589c09148:/# /redis/src/redis-trib.rb check 127.0.0.1:7000
    Connecting to node 127.0.0.1:7000: OK
    Connecting to node 127.0.0.1:7005: [ERR] Sorry, can't connect to node 127.0.0.1:7005
    OK
    Connecting to node 127.0.0.1:7001: OK
    Connecting to node 127.0.0.1:7002: OK
    Connecting to node 127.0.0.1:7003: OK
    Connecting to node 127.0.0.1:7004: OK
    >>> Performing Cluster Check (using node 127.0.0.1:7000)
    M: c6f94a5f136caf7eccf2d207dc5d6cdccdc44885 127.0.0.1:7000
    slots:0-5460 (5461 slots) master
    1 additional replica(s)
    M: 63e73580b843d499b665a7385967268528e836e9 127.0.0.1:7001
    slots:5461-10922 (5462 slots) master
    1 additional replica(s)
    M: 359cc89af7c1654d9fa408ad91abbd1ddc1906f5 127.0.0.1:7002
    slots:10923-16383 (5461 slots) master
    0 additional replica(s)
    S: e7520e9f5c6a43fca5bd1dd3e514278fa036fa80 127.0.0.1:7003
    slots: (0 slots) slave
    replicates c6f94a5f136caf7eccf2d207dc5d6cdccdc44885
    S: f86b2c4604bebddec390f032faa7df484d576afe 127.0.0.1:7004
    slots: (0 slots) slave
    replicates 63e73580b843d499b665a7385967268528e836e9
    [OK] All nodes agree about slots configuration.
    >>> Check for open slots...
    >>> Check slots coverage...
    [OK] All 16384 slots covered.

    On voit bien l’erreur de connexion à l’instance sur le port 7005 mais cela n’a pas d’incidence sur la santé du cluster.

    Que se passe t’il si on arrête un master.

    supervisor> stop redis-2
    redis-2: stopped
    root@4c1589c09148:/# /redis/src/redis-trib.rb check 127.0.0.1:7000
    Connecting to node 127.0.0.1:7000: OK
    Connecting to node 127.0.0.1:7005: OK
    Connecting to node 127.0.0.1:7001: [ERR] Sorry, can't connect to node 127.0.0.1:7001
    OK
    Connecting to node 127.0.0.1:7002: OK
    Connecting to node 127.0.0.1:7003: OK
    Connecting to node 127.0.0.1:7004: OK
    *** WARNING: 127.0.0.1:7004 claims to be slave of unknown node ID 63e73580b843d499b665a7385967268528e836e9.
    >>> Performing Cluster Check (using node 127.0.0.1:7000)
    M: c6f94a5f136caf7eccf2d207dc5d6cdccdc44885 127.0.0.1:7000
    slots:0-5460 (5461 slots) master
    1 additional replica(s)
    S: fa1ba98d286a7db6ad6e4f7b37999d79c2671a97 127.0.0.1:7005
    slots: (0 slots) slave
    replicates 359cc89af7c1654d9fa408ad91abbd1ddc1906f5
    M: 359cc89af7c1654d9fa408ad91abbd1ddc1906f5 127.0.0.1:7002
    slots:10923-16383 (5461 slots) master
    1 additional replica(s)
    S: e7520e9f5c6a43fca5bd1dd3e514278fa036fa80 127.0.0.1:7003
    slots: (0 slots) slave
    replicates c6f94a5f136caf7eccf2d207dc5d6cdccdc44885
    S: f86b2c4604bebddec390f032faa7df484d576afe 127.0.0.1:7004
    slots: (0 slots) slave
    replicates 63e73580b843d499b665a7385967268528e836e9
    [OK] All nodes agree about slots configuration.
    >>> Check for open slots...
    >>> Check slots coverage...
    [ERR] Not all 16384 slots are covered by nodes.

    Le cluster voit bien le problème de connexion à l’instance défaillante.
    il voit aussi qu’il y a un slave qui n’a pas de master. A la dernière ligne, on voit qu’il y a un problème de cohérence sur le cluster car tous les slots de répartition ne sont pas couverts par le cluster

    Mais cela est corrigé quand le slave devient master:

    root@4c1589c09148:/# /redis/src/redis-trib.rb check 127.0.0.1:7000
    Connecting to node 127.0.0.1:7000: OK
    Connecting to node 127.0.0.1:7005: OK
    Connecting to node 127.0.0.1:7002: OK
    Connecting to node 127.0.0.1:7003: OK
    Connecting to node 127.0.0.1:7004: OK
    >>> Performing Cluster Check (using node 127.0.0.1:7000)
    M: c6f94a5f136caf7eccf2d207dc5d6cdccdc44885 127.0.0.1:7000
    slots:0-5460 (5461 slots) master
    1 additional replica(s)
    S: fa1ba98d286a7db6ad6e4f7b37999d79c2671a97 127.0.0.1:7005
    slots: (0 slots) slave
    replicates 359cc89af7c1654d9fa408ad91abbd1ddc1906f5
    M: 359cc89af7c1654d9fa408ad91abbd1ddc1906f5 127.0.0.1:7002
    slots:10923-16383 (5461 slots) master
    1 additional replica(s)
    S: e7520e9f5c6a43fca5bd1dd3e514278fa036fa80 127.0.0.1:7003
    slots: (0 slots) slave
    replicates c6f94a5f136caf7eccf2d207dc5d6cdccdc44885
    M: f86b2c4604bebddec390f032faa7df484d576afe 127.0.0.1:7004
    slots:5461-10922 (5462 slots) master
    0 additional replica(s)
    [OK] All nodes agree about slots configuration.
    >>> Check for open slots...
    >>> Check slots coverage...
    [OK] All 16384 slots covered.

    J’ai modifié le programme Java initié dans le précédent article et je mesure à 6s, le temps pour que le cluster soit de nouveaux opérationnels;

    23:37:19.CEST / res - bar
    23:37:20.CEST / Too many Cluster redirections?
    23:37:21.CEST / Too many Cluster redirections?
    23:37:22.CEST / Too many Cluster redirections?
    23:37:23.CEST / Too many Cluster redirections?
    23:37:24.CEST / Too many Cluster redirections?
    23:37:25.CEST / CLUSTERDOWN The cluster is down
    23:37:26.CEST / res - bar

    Il est peut être possible de jouer sur le paramétrage pour descendre ce temps, mais je n’ai pas encore trouvé comment.

    On voit bien ici le problème lorsque que les données ne soit pas répliquées entre les différents masters. Lorsqu’un master est absent, il y a un « petit » laps de temps ou les données ne sont pas connues.
  • Redis Cluster en java

    En commençant à regarder le mode cluster de redis à travers une image docker déjà construire https://github.com/Grokzen/docker-redis-cluster, je me suis aperçu que ce n’est pas si transparent. En effaçant, si on essaye d’ajouter une valeur mais que la clé ne correspond au bon noeud, redis ne renvoi pas OK mais plutôt l’indication de ou insérer la donnée:

    $ redis-cli -p 7000
    127.0.0.1:7000> set toto foo
    (error) MOVED 9738 127.0.0.1:7001

    Je me suis demandé comment gérer cela dans un programme Java. Est-ce le driver qui va faire le travail ou il faut le gérer à la main.

    Si on utilise le driver standard de Jedis, voici ce qu’on obtiens:

    Jedis jedis=new Jedis("localhost",7000);
    jedis.connect();
    jedis.set("toto","bar");
    String value=jedis.get("toto");
    System.out.println("res - "+value);
    Exception in thread "main" redis.clients.jedis.exceptions.JedisMovedDataException: MOVED 9738 127.0.0.1:7001
    at redis.clients.jedis.Protocol.processError(Protocol.java:108)
    at redis.clients.jedis.Protocol.process(Protocol.java:142)
    at redis.clients.jedis.Protocol.read(Protocol.java:196)
    at redis.clients.jedis.Connection.readProtocolWithCheckingBroken(Connection.java:288)
    at redis.clients.jedis.Connection.getStatusCodeReply(Connection.java:187)
    at redis.clients.jedis.Jedis.set(Jedis.java:66)
    at com.axioconsulting.redis.TestCluster.main(TestCluster.java:21)
    at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method)
    at sun.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:62)
    at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)
    at java.lang.reflect.Method.invoke(Method.java:497)
    at com.intellij.rt.execution.application.AppMain.main(AppMain.java:140)

    Heureusement, Jedis propose une classe pour résoudre ce problème (Je n’ai rien trouvé coté JRedis).

    Set jedisClusterNodes=new HashSet(); jedisClusterNodes.add(new HostAndPort("localhost",7000)); 
    jc.set("toto","bar");
    String value=jc.get("toto");
    System.out.println("res - "+value);
    res - bar


    Le driver est même capable de récupérer les autres noeuds. Dans l’exemple j’ai indiqué un seul noeud, mais avec le code suivant :

    for (Map.Entry<string,jedispool> entry:jc.getClusterNodes().entrySet()){
       System.out.println(entry.getKey());
    }

    on voit bien que le driver a pu récupérer les autres noeuds:

    localhost:7000
    127.0.0.1:7004
    127.0.0.1:7005
    127.0.0.1:7002
    127.0.0.1:7003
    127.0.0.1:7000
    127.0.0.1:7001


    les sources sont ici

    Quelques liens utiles:
    – commandes redis cluster

    – À la découverte de Redis Cluster 3.0